Nummerierte Schritte
Behandle jeden Durchlauf als kontrolliertes Experiment. Notiere die Dataset-Version, Einstellungen, den Checkpoint und Beispielausgaben, damit ein vielversprechendes Ergebnis später reproduziert und nicht nur erraten werden kann.
-
1
Definiere ein Lernziel
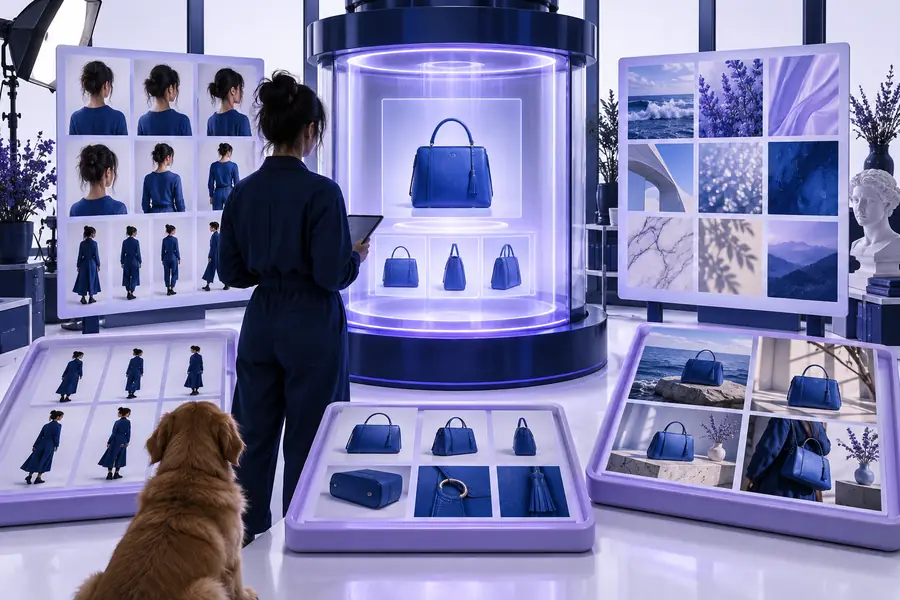
Formuliere ein einzeiliges Ziel, etwa eine Charakteridentität, Produktform oder einen visuellen Stil. Entferne Bilder, die themenfremde Motive, inkonsistente Anatomie, Wasserzeichen oder ablenkende Kompositionen vermitteln. Ein eng gefasstes Ziel liefert dem Adapter ein klareres Signal.
-
2
Bereite das Dataset vor und versehe es mit Captions
Verwende saubere, vielfältige Bilder mit einheitlichen Abmessungen und aussagekräftigen Captions. Beschreibe das Motiv und wichtige Beziehungen, aber wiederhole kein Triggerwort so, als würde es jedes visuelle Detail erklären. Überprüfe die Zuschnitte manuell, halte Dateinamen vorhersehbar und trenne Trainingsbilder von Validierungsbildern.
-
3
Führe eine konservative Baseline aus
Beginne mit moderaten Einstellungen und speichere in regelmäßigen Abständen Checkpoints. Teste dieselben Prompts gegen das Basismodell und mehrere gespeicherte Versionen. Vergleiche, ob das Ziel zuverlässiger erscheint, ohne übermäßige Artefakte, Steifheit oder einen Verlust der Prompt-Kontrolle.
-
4
Validiere vor der Veröffentlichung
Verwende Prompts, die nicht aus den Trainings-Captions kopiert wurden. Teste verschiedene Seeds, Motive, Hintergründe und Stärken. Behalte die Version, die sich über verschiedene Prompts hinweg verallgemeinert, nicht lediglich den Checkpoint, der in einer einzigen auswendig gelernten Komposition am stärksten wirkt.