ショーケース
始める前に他の人の作品を見る
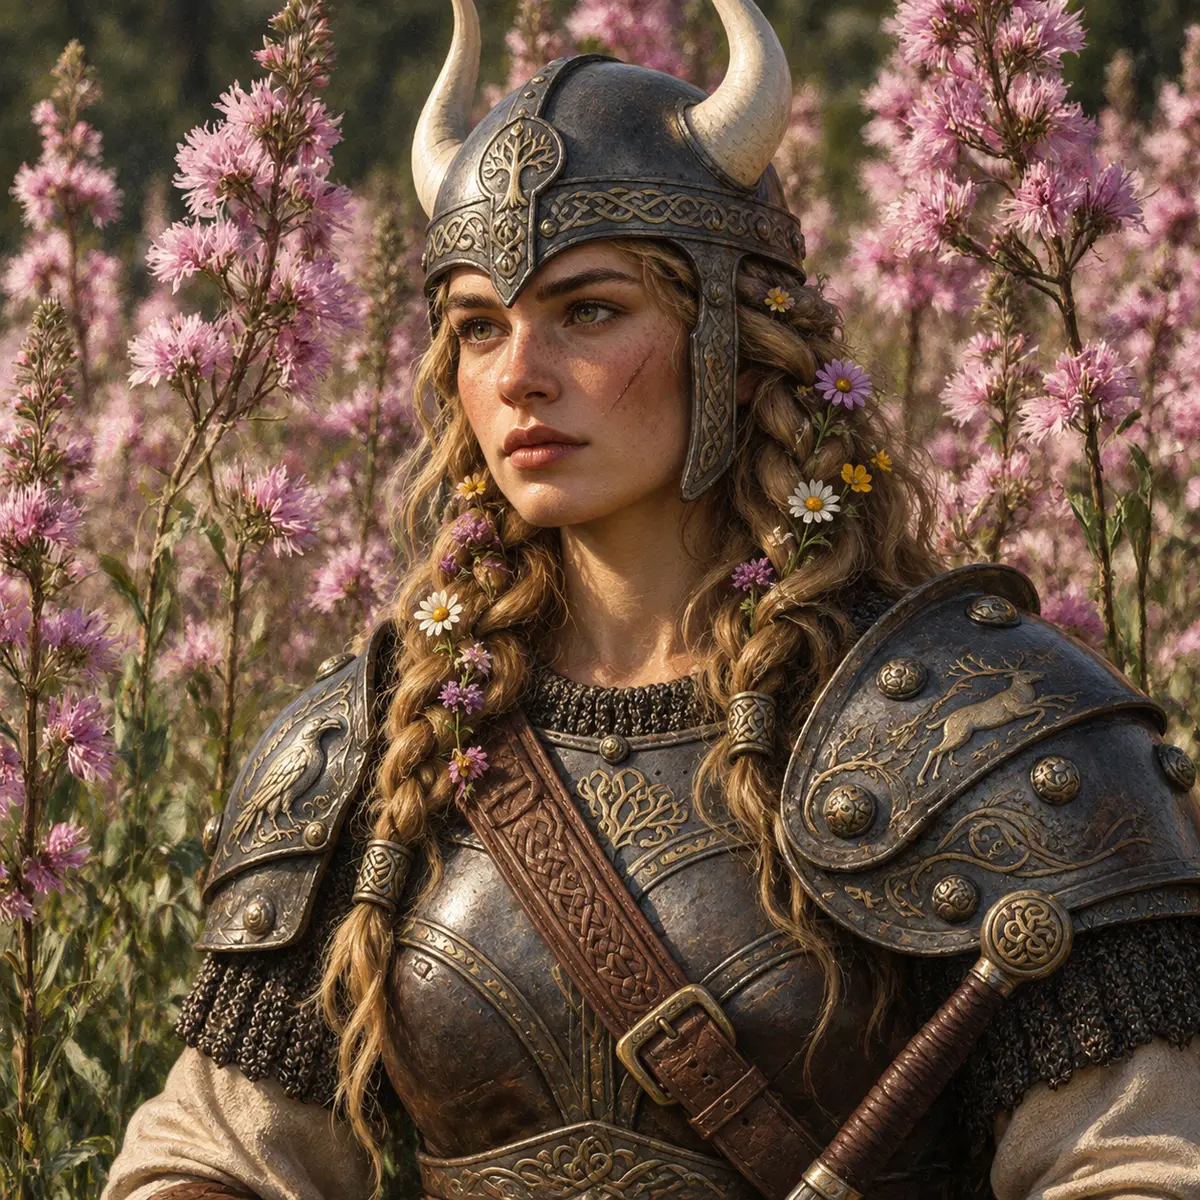
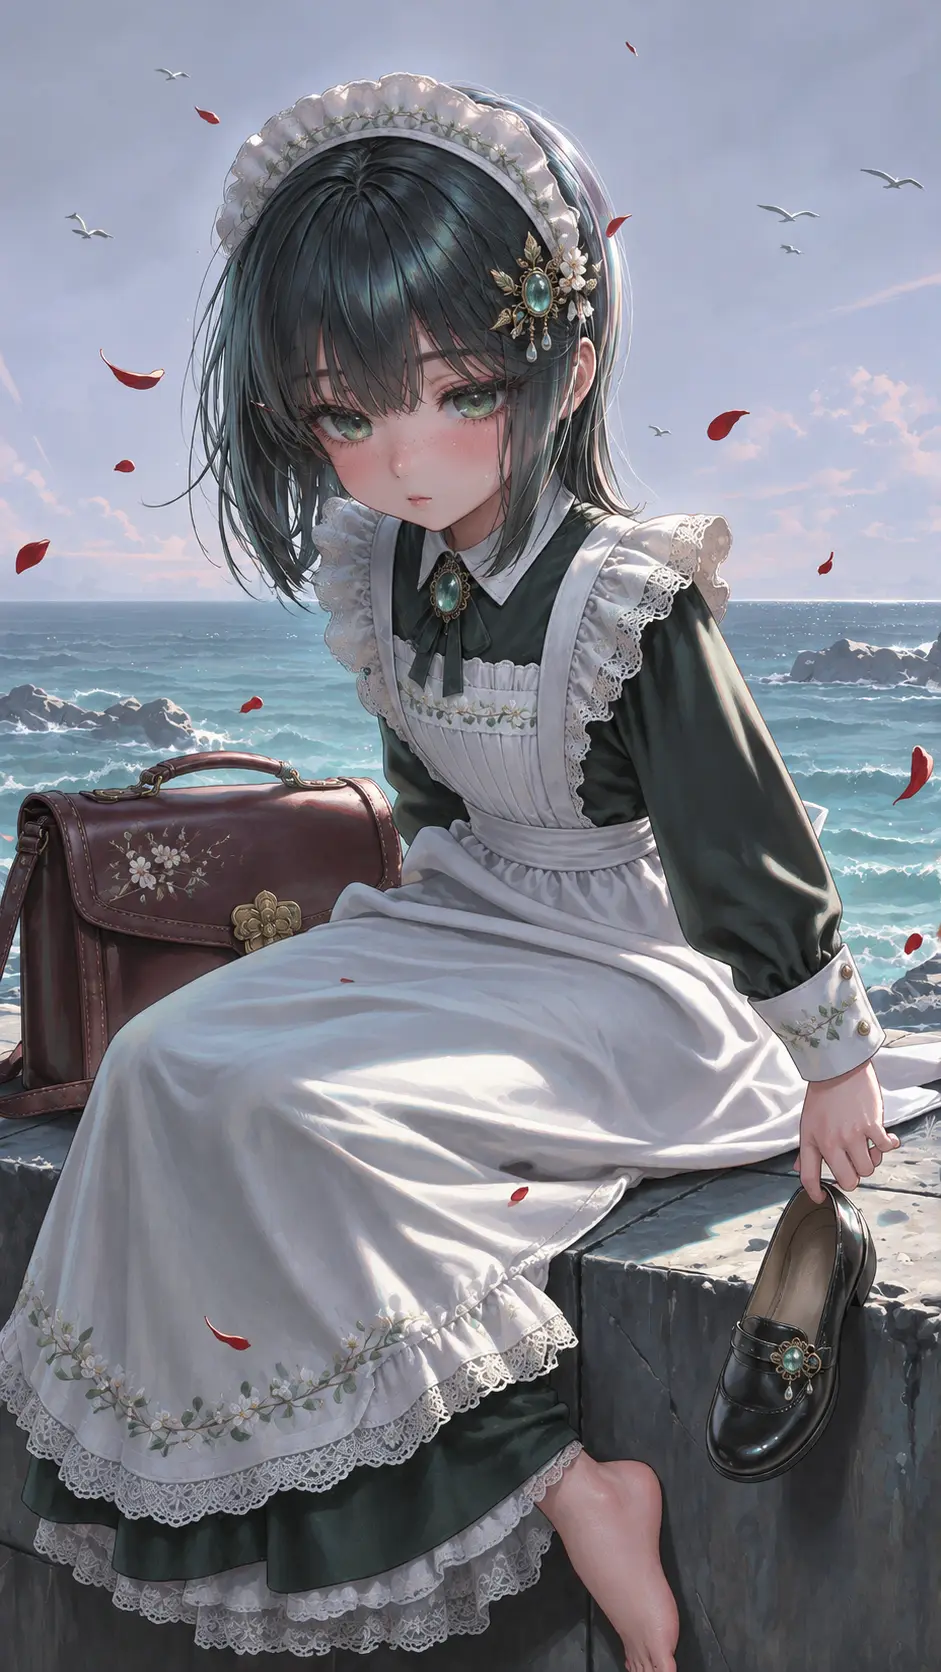
コミュニティのLoRAで作られたポートレート、アニメ、製品、キャラクターのスタイル。
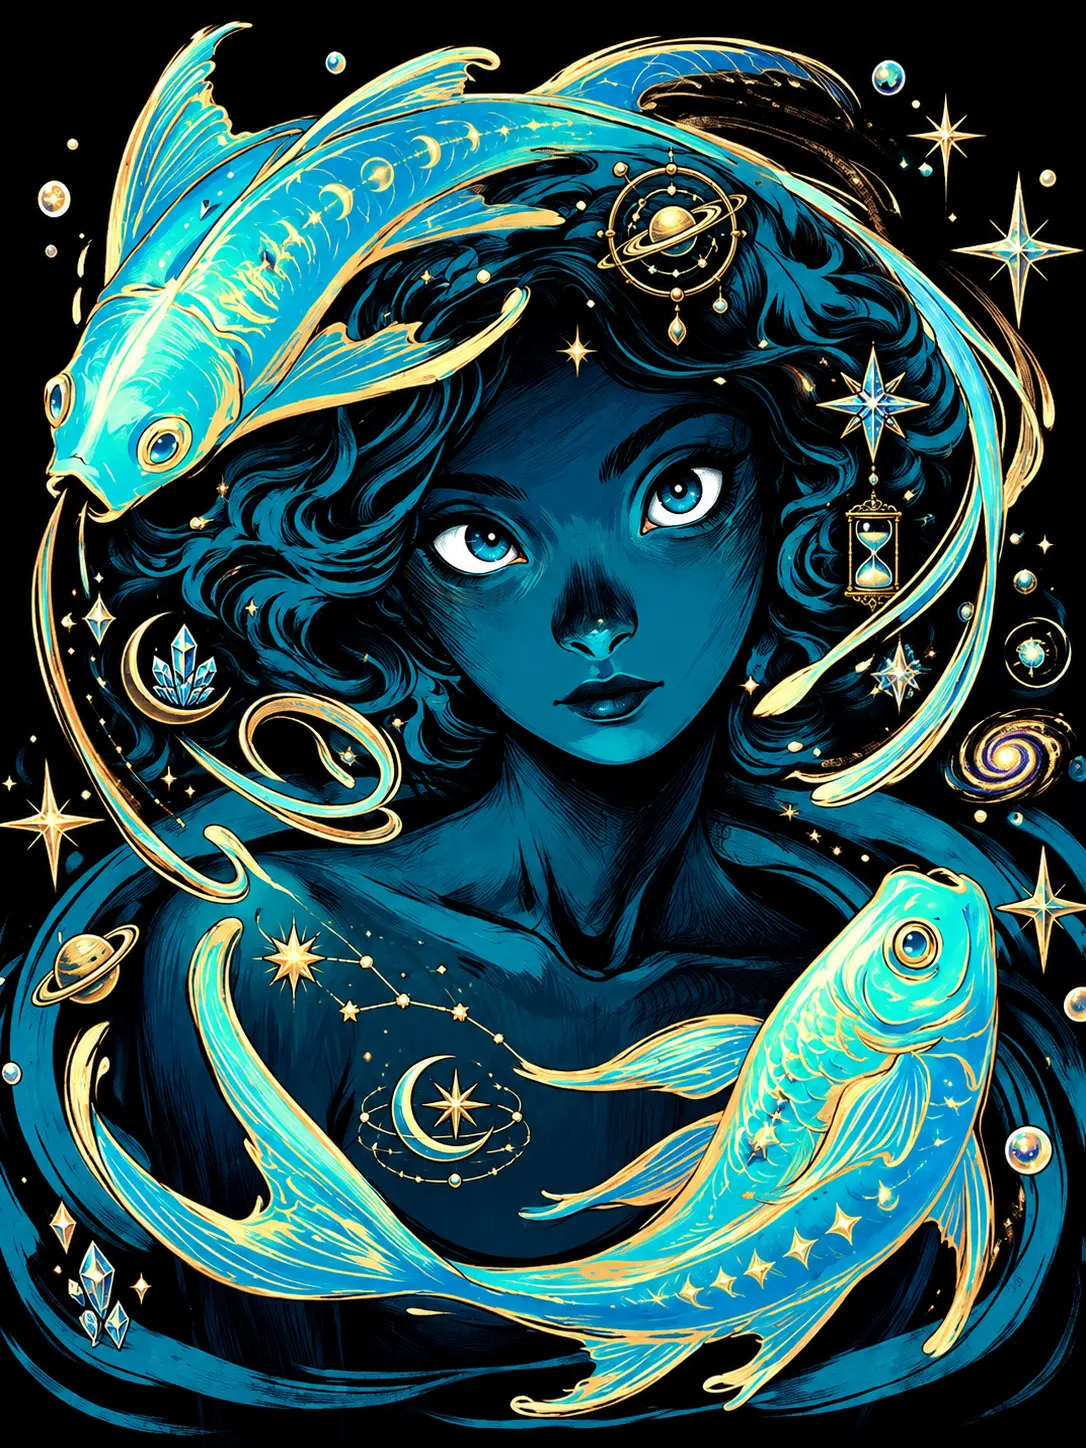
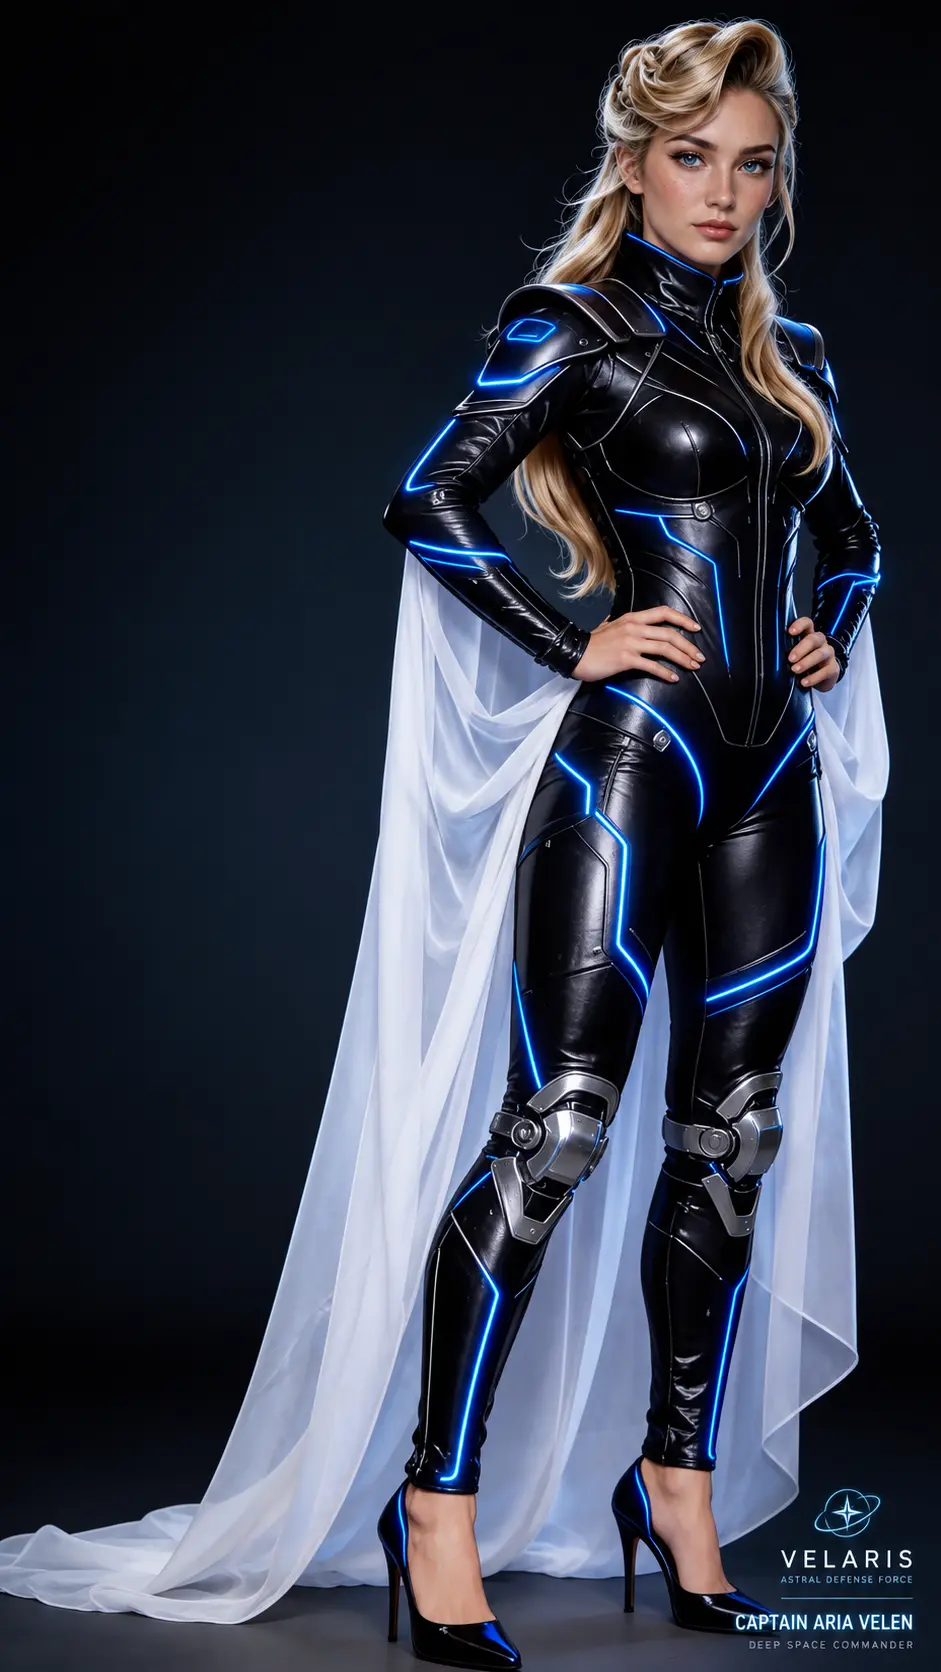
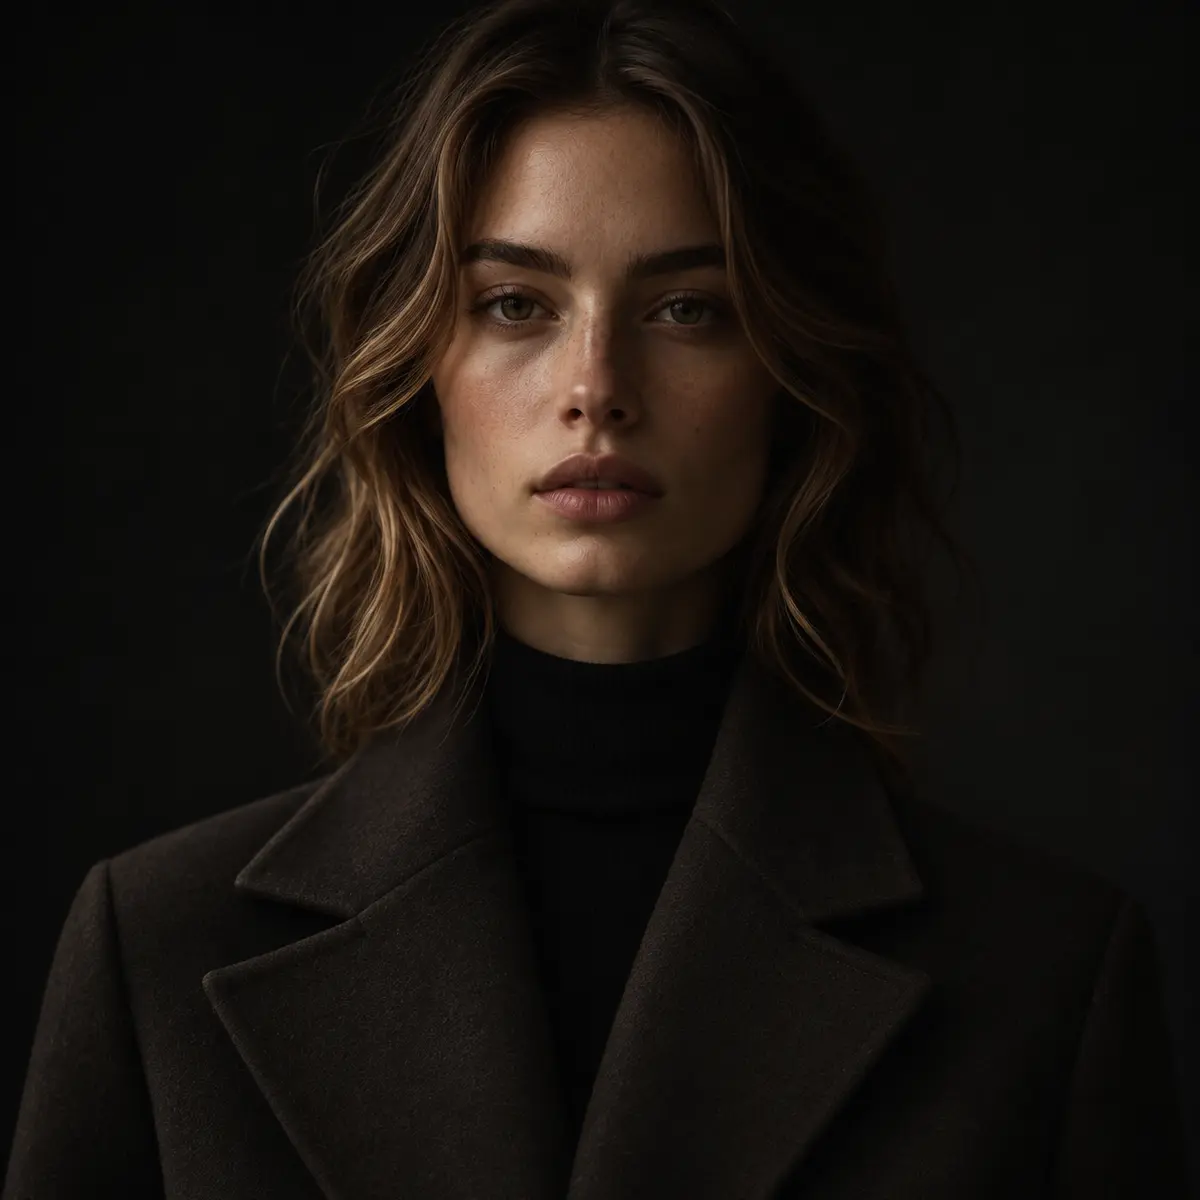
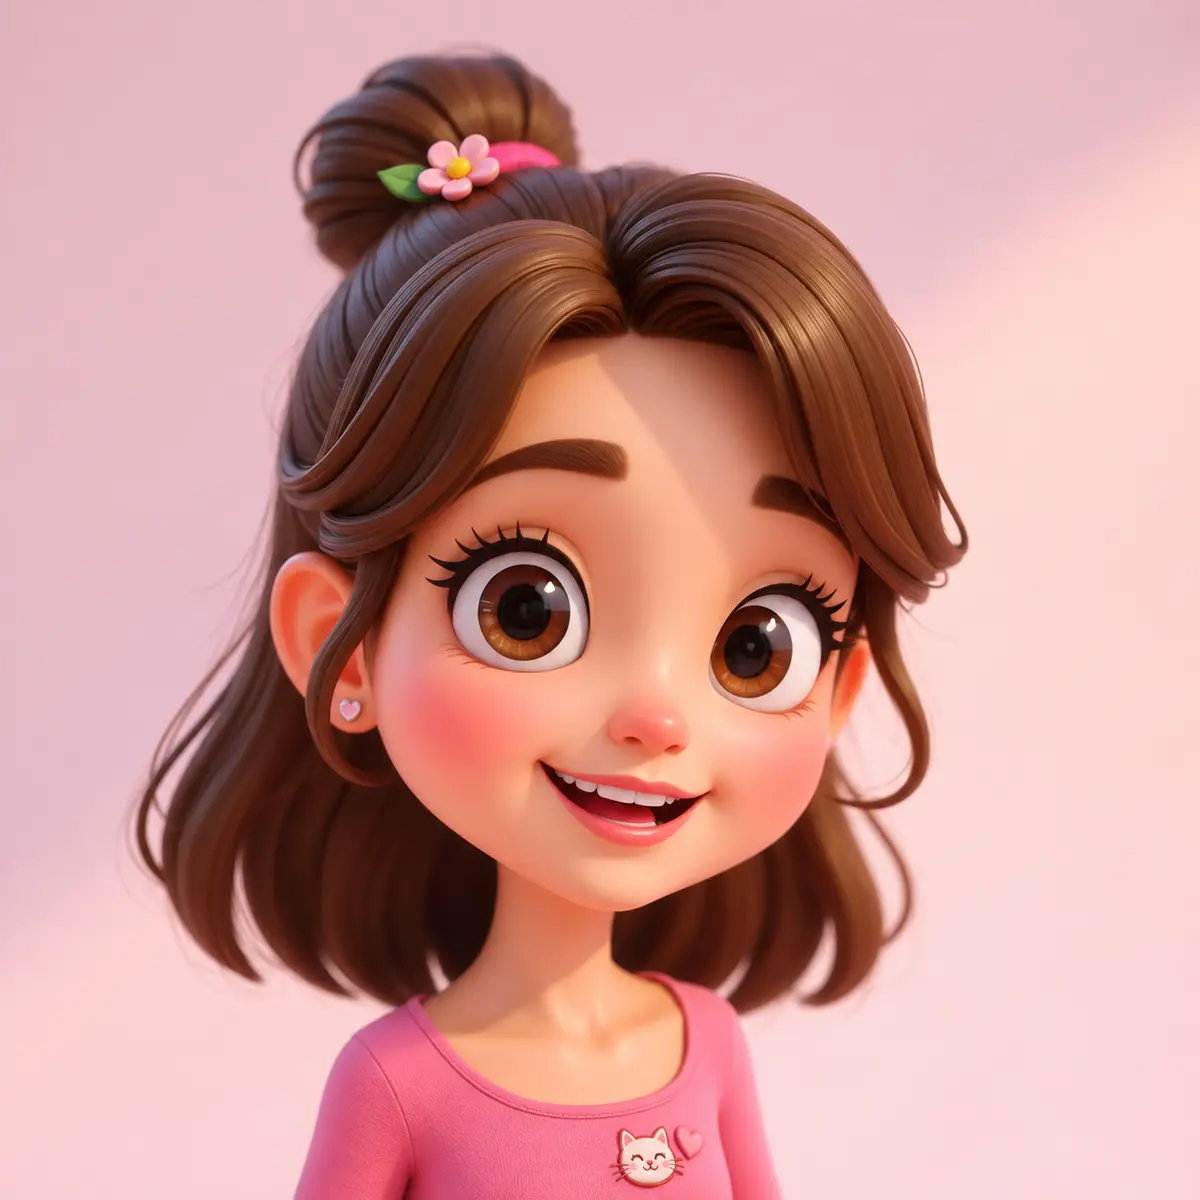
今日は何を作りますか?
画像、モーション、または独自にトレーニングしたモデルから始めましょう。
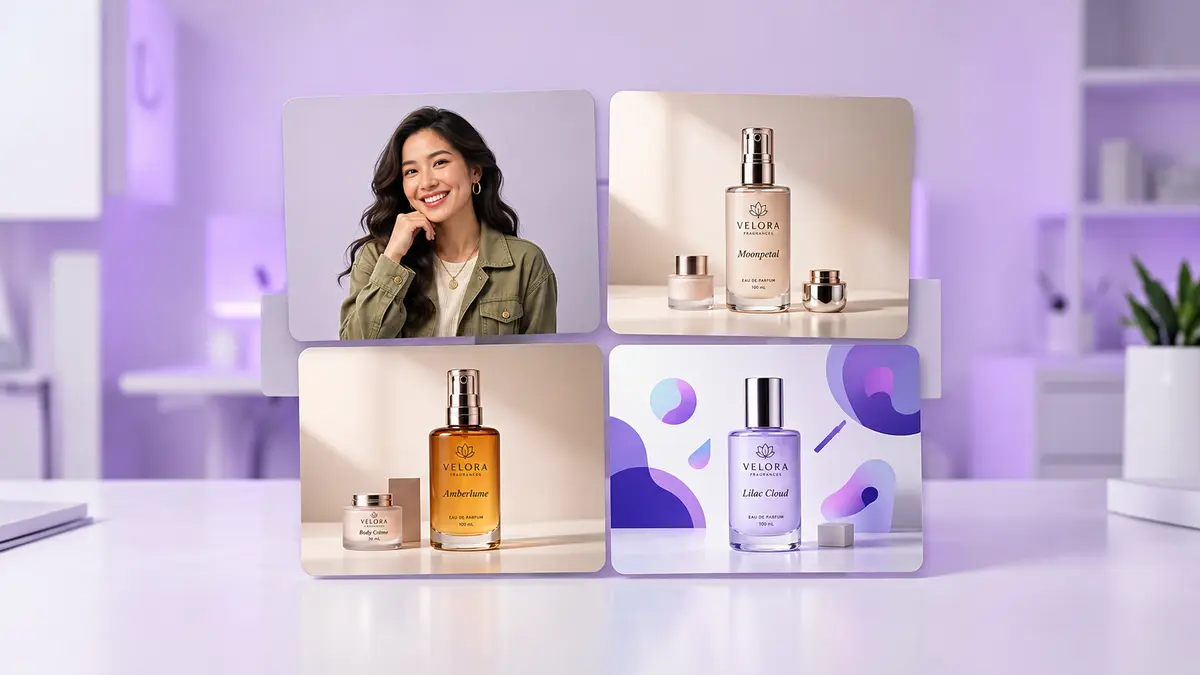
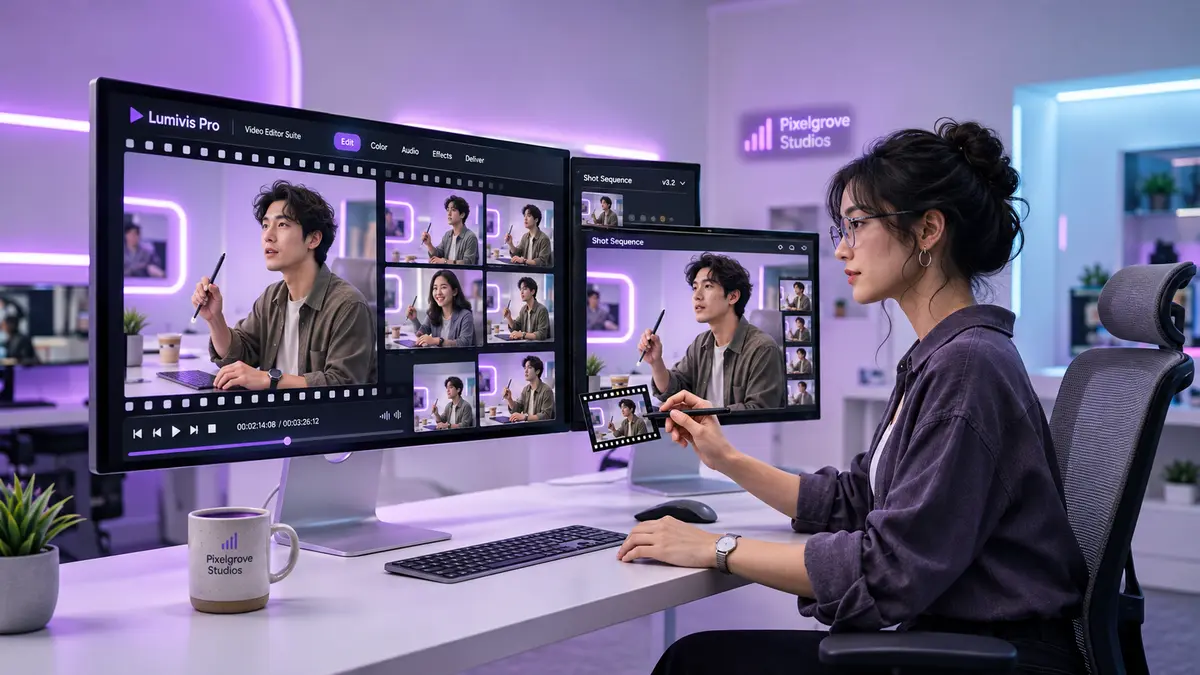
認識可能であり続ける必要があるキャラクターや製品のために設計
チャットツールは単発のアイデアに向いています。学習済みLoRAなら、数百回のレンダリングにわたって同じ顔、製品、スタイルを維持できます。
ベースモデルを再トレーニングせずに適応させる
LoRA は Low-Rank Adaptation の略で、大規模モデルに顔、オブジェクト、スタイルを教える小さなアドオンであり、完全な再トレーニングを省略できます。
ベース vs LoRA vs カスタム
ベースモデル
幅広く素早いが、同じ見た目を繰り返し必要とする場面ではぶれる。
LoRA
スタイルや被写体をより精密に制御するための動作を追加します。
カスタム LoRA
マスコット、製品ライン、ビジュアルシステムを設定どおりに保ちます。
クリエイターが採用する理由
キャラクター、製品、ブランドシーンがバッチ全体を通じて安定します。
独自に学習すべきタイミング
人物、コレクション、マスコット、ハウススタイルを正確に繰り返す必要がある場合。
始め方
まず生成し、次に動きを加え、見た目を再利用する必要が生じたら学習します。
ユースケース
学習済みスタイルでリリースできる実プロジェクト
Lora AIは、単一のプロンプトより厳密な制御が必要な、繰り返し登場するキャラクター、製品キャンペーン、動画ドラフトに適しています。
画像ジェネレーターの特長
Lora AI が日々のクリエイティブ作業にもたらすものを短く紹介します。
高速な反復のために設計
プロンプト、スタイル、シードを並べて切り替え、長い書き直しではなく短いループでアイデアを磨き上げます。
豊富なモデルライブラリ
フォトリアル、アニメ、イラスト調のベースを選べ、それぞれにそのルック向けに調整されたLoRAが組み合わされています。
シンプルさを重視した設計
コードやノードグラフは不要です。入力してスタイルを選び、調整できます。詳細オプションはすっきりと隠されています。
既存のスタックに適合
学習済みウェイトは一般的な形式を使用しているため、SDXL、ComfyUI などの同様のパイプラインにそのまま組み込めます。
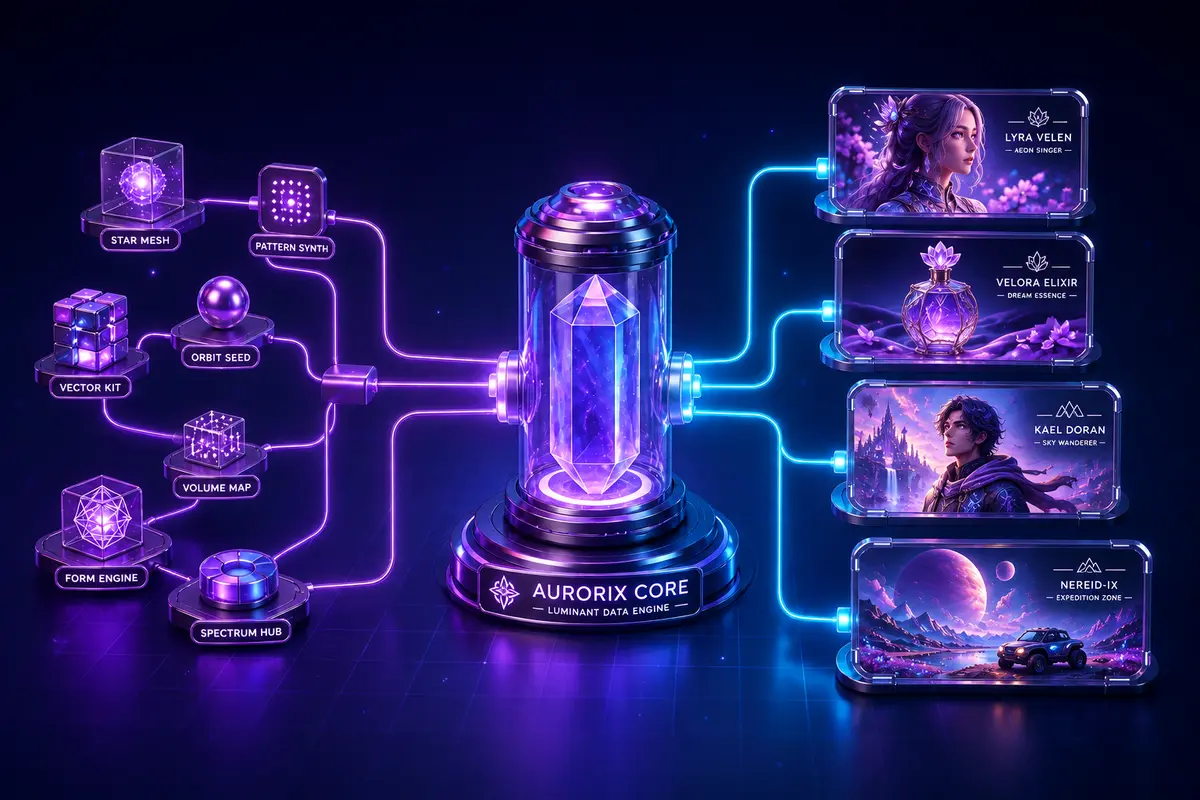
3ステップでわかる仕組み
アイデアから完成画像まで、学習の負担なく。
アイデアを描写する
思い描いたことを平易な言葉で書くだけで、意図、雰囲気、細部まで反映されます。
スタイルを選ぶ
既製のLoRAを探すか、自分で学習させたモデルを読み込みます。
レンダリングしてエクスポート
バリエーションを比較し、お気に入りを保存して、あらゆるプロジェクト用にダウンロードできます。
チームがLora AIを選ぶ理由
静止画・動画・学習をひとつにまとめたスタジオ。
すべてがひとつのワークスペースを共有するため、一度作ったルックはその後どのプロジェクトでもすぐに使えます。
最新モデル
新しいリリースが登場するたびにベースとLoRAが更新されます。
安定したレンダリング
分散GPUにより、忙しい日も無理なくこなせます。
慎重な取り扱い
アカウント、アップロード、出力は非公開で取り扱われます。
柔軟なワークフロー
画像、動画、学習の間を自由に行き来できます。
最初のルックを作成する準備はできましたか?
トレーニング済みのスタイルを活用して作品の一貫性を保つクリエイターに加わりましょう。
よくある質問
Lora AIとは?
Lora AIは、画像生成、ショート動画の作成、独自のLoRAアダプターのトレーニングができるブラウザスタジオです。
レンダーを商用利用できますか?
ベースモデルのライセンスによって異なります。公開前にモデルカードを確認してください。
LoRAはベースモデルとどう違いますか?
ベースモデルはあらゆる分野に少しずつ対応できますが、LoRAはそれを特定の被写体やスタイルへ導きます。
独自のLoRAをトレーニングできますか?
はい。画像セットをアップロードしてトレーニングを実行し、その結果を任意の生成で読み込めます。
LoRAは動画に使えますか?
はい。トレーニング済みのルックは、対応する動画モデルを通じてショートクリップに反映できます。
まずデータセットが必要ですか?
いいえ。既製スタイルから始め、カスタムモデルが必要なときだけ画像を集めてください。
良いデータセットには何枚の画像が必要ですか?
約20枚の鮮明で変化に富んだ写真は、枚数が多くても単調なセットよりたいてい優れています。
LoRAファイルのサイズはどのくらいですか?
通常は数十~数百メガバイトで、変更対象のベースモデルよりはるかに小さいです。