実践的な比較
適切な画像ワークフローを選ぶ Lora AI vs Stable Diffusion
このLoRA AIとStable Diffusionの比較では、モデルアダプターと生成システムを分けて説明し、それらがどのように連携するかを紹介します。一貫性があり、思い通りに制御できる画像を作成するための実践的な方法を選ぶ際に役立ててください。
これらの関連ガイドでは、同じ判断に影響しやすいモデル形式と代替手段について説明しています。
結論
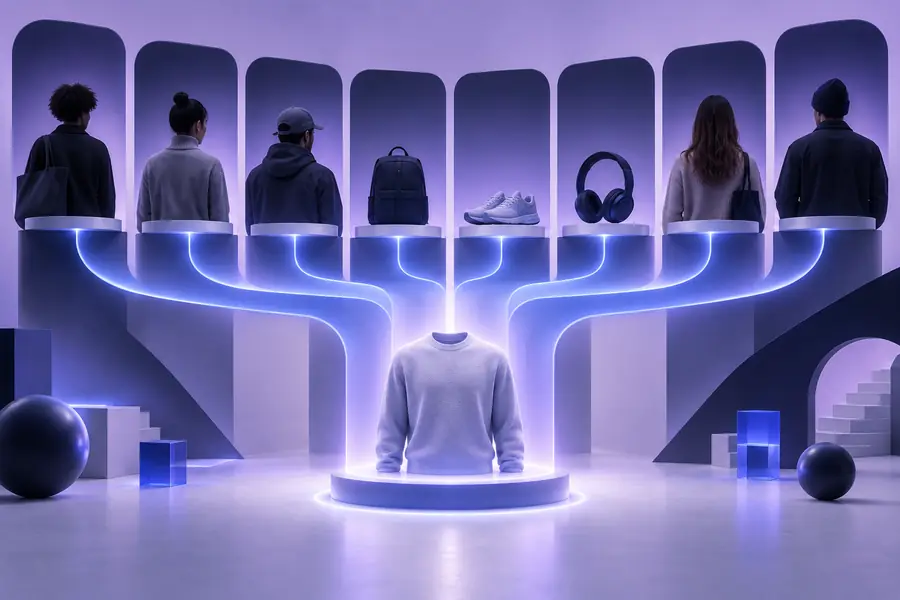
Lora AIとStable Diffusionは、直接置き換えられるものではありません。Stable Diffusionは画像生成エコシステムの基盤であり、LoRAはベースモデルが生成できるものを変えるコンパクトな追加要素です。
-
1
まずベースモデルから始める
Stable Diffusionは、一般的な視覚知識、サンプリング処理、プロンプトの解釈、画像生成パイプラインを提供します。
-
2
特化型アダプターを追加する
LoRAを使えば、ベースチェックポイント全体を置き換えることなく、キャラクター、製品、服装のスタイル、ビジュアルアイデンティティ、被写体を学習させられます。
-
3
バランスを調整する
LoRAの重み、プロンプト、サンプラー、解像度を調整し、構図や人体の構造を損なわずに追加した概念が表れるようにします。
項目別に見る
最も明確な答えは、生成プラットフォーム、ベースモデル、またはそのプラットフォーム内で使用するアダプターのどれを指しているかによって異なります。
- 1 Stable Diffusionのチェックポイントは、画像生成の一般的な基盤を提供する
- 1 ベース
- 2 LoRAは既存のモデルに特定の概念を追加できる
- 1 アダプター
- 3 プロンプト、モデルの選択、アダプターの重みが最終結果を左右します
- 3 制御
- 4 手軽さを重視するならホスト型ワークフローを、より細かな制御を求めるならローカル環境を使用します
- 2 パス
項目ごとに比較
各用語が画像ワークフローにどのような役割を果たすのかを区別するために、この表を使用してください。互いに競合する製品として捉えるものではありません。
Lora AI
Stable Diffusion
概要
Lora AI
互換性のある画像モデルに影響を与えるように学習された、低ランクアダプター。
Stable Diffusion
テキストから画像を生成するモデル群と、それを中心に構築されたエコシステム。
主な役割
Lora AI
特定のアイデンティティ、スタイル、対象、または視覚的な振る舞いを追加します。
Stable Diffusion
画像を生成し、幅広い視覚的知識を提供します。
一般的なサイズ
Lora AI
通常、完全なチェックポイントよりもはるかに小さいサイズです。
Stable Diffusion
ベースチェックポイントは大幅に大きく、モデルの主要な重みを保持しています。
制御
Lora AI
重みやプロンプトの変更を通じて、1つの学習済み概念を集中的に制御します。
Stable Diffusion
構図、レンダリング、プロンプト、サンプリング、モデル選択を幅広く制御します。
学習の目的
Lora AI
比較的少量の画像セットを使用して、限定的な概念を効率的に学習させます。
Stable Diffusion
汎用の生成モデルを作成またはファインチューニングします。
ワークフローの依存関係
Lora AI
互換性のあるベースモデル、インターフェース、トリガーとなる文言が必要です。
Stable Diffusion
LoRAなしでも生成できますが、拡張機能によって機能を広げられます。
最大の強み
Lora AI
キャラクター、製品、スタイル、または被写体の挙動を再現できます。
Stable Diffusion
幅広い被写体やビジュアルの方向性に対応した柔軟な画像作成。
主なトレードオフ
Lora AI
学習状態が悪い、または互換性のないアダプターは、アーティファクトを発生させ、柔軟性を低下させる可能性があります。
Stable Diffusion
通常のベースモデルでは、非常に具体的なアイデンティティや一貫した被写体の再現に苦労する場合があります。
それぞれのアプローチに適した人
どちらの用語がより高度に聞こえるかではなく、解決したい問題に基づいて選びましょう。
-
LoRAは完全な生成モデルではありません
通常、アダプター単体では使用できません。互換性のあるStable Diffusionファミリーのモデルと、それを読み込めるツールが必要です。
回避策まずベースチェックポイントを選び、その後、アダプターがそのモデルファミリー向けに学習されていることを確認してください。
-
Stable Diffusionは一貫性を保証しません
汎用チェックポイントでは魅力的な画像を生成できても、プロンプトを変えるたびにキャラクターの顔、服装、製品の細部が変わることがあります。
回避策再現性が重要な場合は、特化型LoRA、リファレンス制御、シード、または画像から画像へのワークフローを使用してください。
-
アダプターを増やすと信頼性が低下することがあります
複数のLoRAを重ねると、スタイルの競合、人体の問題、細部の混濁、予期しないプロンプトの相互作用が生じることがあります。
回避策まずは中程度のウェイトで1つのアダプターから始め、その効果が明確な場合にのみ別のアダプターを追加します。
-
ローカル環境の操作には学習コストがかかる
ローカルのStable Diffusion環境ではより多くの設定を利用できますが、モデルファイル、メモリ制限、ノード、サンプラーの選択が初心者の作業を遅くすることがあります。
回避策まずはガイド付きのオンラインワークフローから始め、設定を再現可能にしたい場合やプライベートなファイルを扱いたい場合にローカル環境へ移行します。
実践的な移行方法
最も簡単な移行方法は段階的に進めることです。すでに機能しているワークフローを維持し、実際に必要な制御だけを追加します。
- ベースモデルのみ
- ベースモデルとLoRA
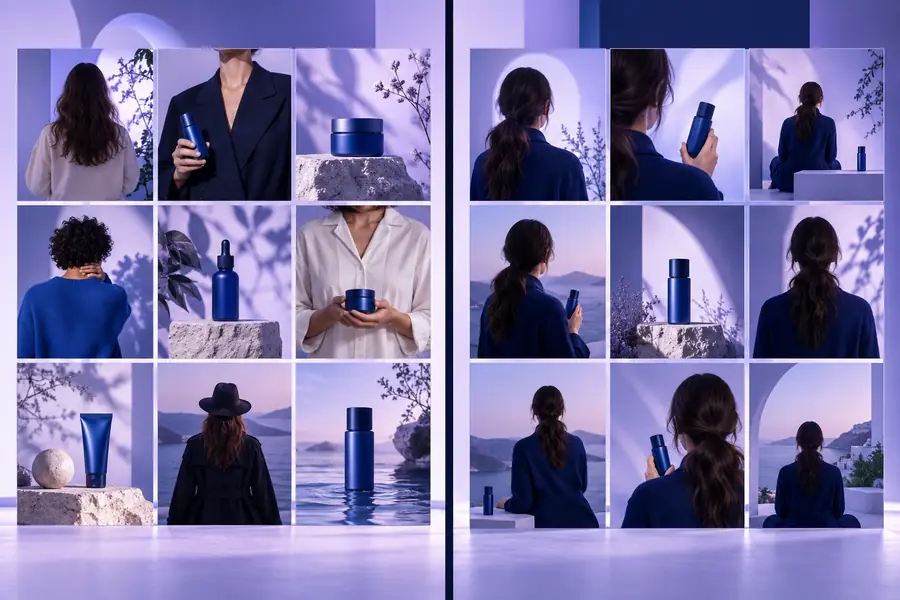
幅広い探索から、焦点を絞った制御へ移行します。互換性のあるチェックポイントを選び、質の高いベースラインプロンプトを再現し、LoRAを1つ追加して、複数のウェイトで出力を比較します。テスト中は、アダプターが役立っているか判断できるよう、プロンプト、シード、解像度、サンプラーを一定に保ちます。結果がスタイルに寄りすぎる場合はウェイトを下げ、被写体が消えてしまう場合はトリガーの文言を強めるか、より適合するアダプターを使用します。出力が安定したら、その組み合わせを再利用可能なレシピとして保存します。この方法なら、初心者でもすべての設定を一度に学ぶことなくStable Diffusionを使い始められ、後から高度な制御へ進む余地も残せます。
比較を実践的に行う
画像生成を始めるのに最適な方法を見つける
LoRAとStable Diffusionを、互いに競合する生成ツールであるかのように、どちらか一方から選ぶ必要はありません。まずはベースワークフローから始め、解決したい一貫性やスタイルの問題を特定し、測定可能な改善が得られる場合にのみ、目的に合ったアダプターを追加します。
画像ワークフローを試す- ガイド付きの生成方法を試す
- すべてを作り直さずに、特定のコンセプトをテストする
- 幅広いプロンプトから、再現可能な結果へ移行する
比較に関するよくある質問
これら2つの用語を比較する際によく寄せられる質問への簡潔な回答です。
いいえ。Stable Diffusionは画像生成の基盤となるモデルファミリーおよびエコシステムであり、LoRAは互換性のあるベースモデルを変更する軽量なアダプターです。両者は互いの代わりに選ぶものというより、併用されることが多いものです。
通常の画像生成ワークフローでは、ほとんどの場合できません。LoRAは互換性のあるモデルとインターフェースに読み込む必要がありますが、そのインターフェースによっては、内部のStable Diffusionコンポーネントが見えない場合もあります。
特定のキャラクター、製品、またはビジュアルアイデンティティを繰り返し再現することが目的なら、一般的にはLoRAの方が適しています。Stable Diffusionは生成の基盤を提供しますが、アダプターによって学習された特徴を絞り込んで付加することで、一貫性が向上します。
いいえ。アダプターがベースモデル、プロンプト、目的の対象に適合している場合にのみ、画像が改善されます。互換性のないLoRAや学習状態の悪いLoRAは、アーティファクトを生じさせたり、構図を弱めたり、結果の柔軟性を低下させたりする可能性があります。
初心者はまずベースとなる生成ワークフローを理解し、その後、キャラクターやスタイルなど明確な目的に合わせてLoRAを1つ追加するとよいでしょう。ガイド付きのオンラインツールならセットアップの負担を軽減できます。一方、モデルや設定を細かく制御したい場合は、ローカル環境でのStable Diffusionワークフローが適しています。